체성분 결과지에서 숫자와 그림을 따로 검증한 이유
체성분 결과지를 항목별로 대조하며 자동 입력에 포함할 범위를 정했다.
왼팔의 ‘표준이하’가 몸통으로 옮겨 갔다. 같은 사진으로 다섯 번 돌렸는데, 다섯 번 다 똑같이 그렇게 읽었다.
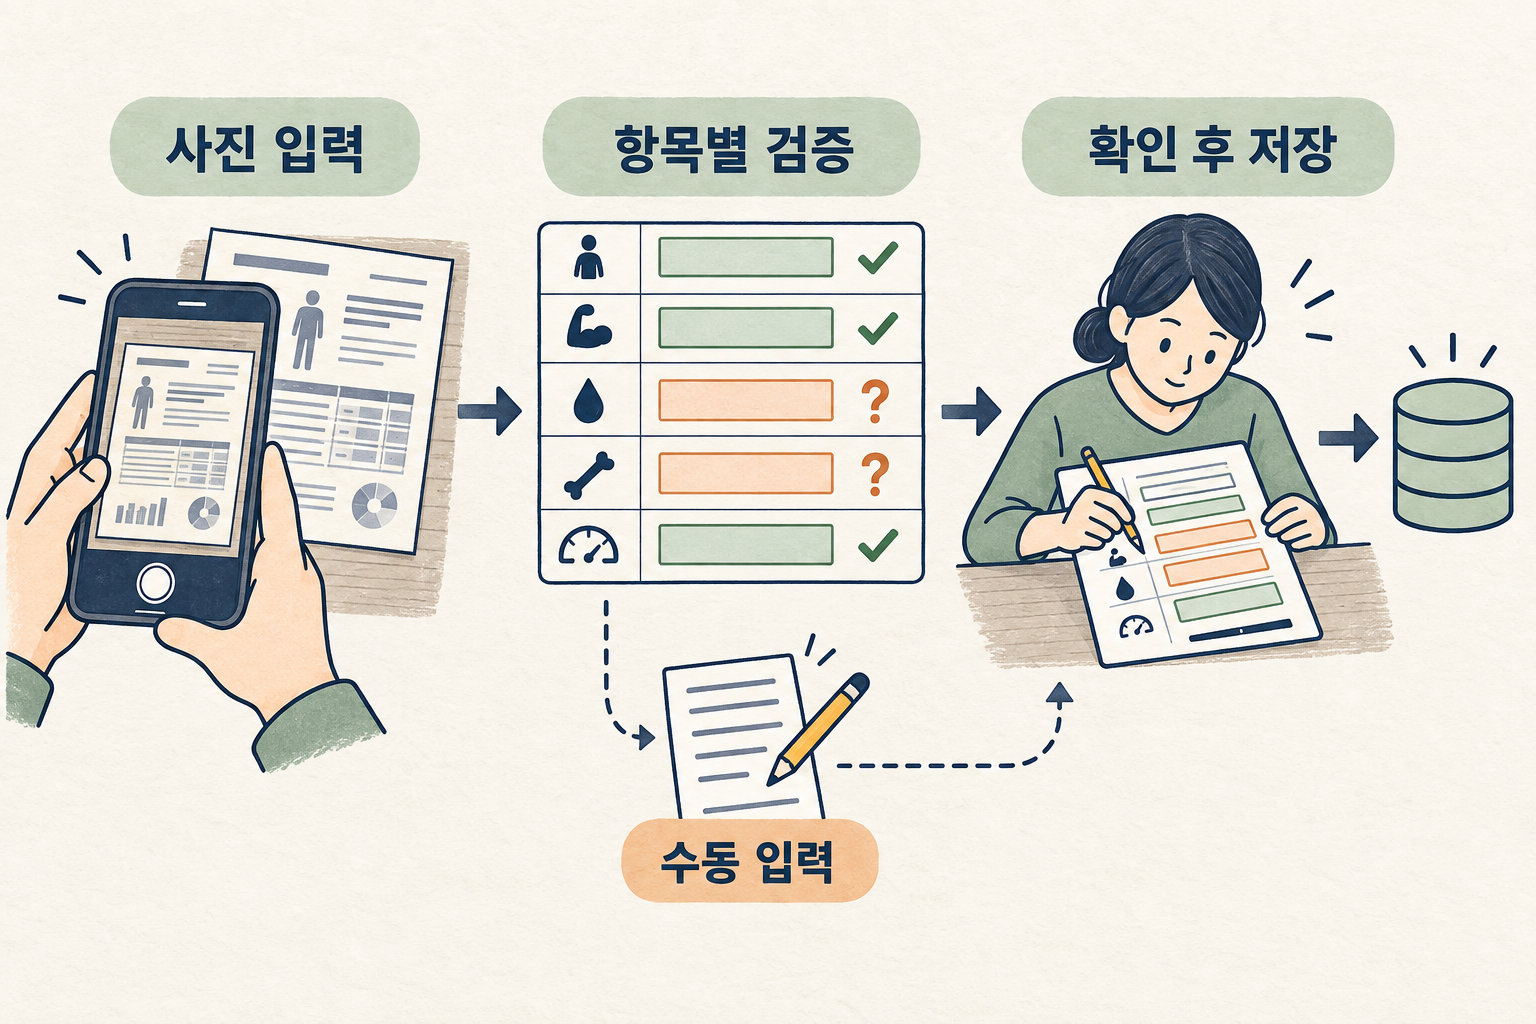
피트니스 회원 앱에 체성분 결과지를 사진으로 입력하는 기능을 검토하고 있었다. 체중이나 골격근량, 체지방률을 손으로 옮겨 적는 대신 멀티모달 모델에 사진을 넣고 정해진 JSON으로 값을 받아 입력 칸을 채우는 방식이다.
항목마다 읽는 방법이 달랐다
결과지에는 성격이 다른 정보가 섞여 있다. 숫자로 적힌 측정값이 있고, 적정체중이나 권장섭취열량 같은 조절·권장값이 있다. 팔·다리·몸통 그림에는 ‘표준’, ‘표준이하’ 같은 판정이 선으로 이어져 있다. 사진에 아예 없는 항목도 있다.
그래서 출력 형식을 JSON Schema로 고정하고 항목을 핵심 지표와 선택 지표로 나눴다. 못 읽은 값은 null로 받는다. 0으로 바꾸지도, 다른 값으로 계산해서 채우지도 않는다. 형식이 맞는다고 값이 맞는 건 아니라서 날짜·단위·범위는 따로 검증한다. 모델이 준 값은 바로 저장하지 않고 사용자가 확인하고 고친 다음에 저장한다. 분석이 실패하면 손으로 입력하면 된다.
같은 사진으로 다섯 번
모델은 Kimi K2.5로 골랐다. 그다음 더 많은 항목을 읽을 수 있는지 실험했다. 처음엔 핵심 3개 지표만 저장하자는 제안이었는데, 기획이 체지방량·BMI·체성분 분석 점수·기초대사량까지 더하는 쪽으로 넓어졌기 때문이다.
전처리한 같은 사진과 같은 스키마로 다섯 번 호출했다. 세 번은 기본 지시문, 두 번은 한글 항목명·날짜 형식·연결선 확인을 보탠 지시문이었다. 사람이 읽은 정답은 따로 두고 모델에게는 주지 않았다.
| 평가 대상 | 기본 지시문 3회 | 보완 지시문 2회 |
|---|---|---|
| 현재 숫자 지표 14개 | 13/14, 14/14, 13/14 | 14/14, 14/14 |
| 결과지 조절·권장값 5개 | 모두 5/5 | 모두 5/5 |
| 사진에 없는 숫자 22개 | 모두 null 유지 | 모두 null 유지 |
| 부위별 근육 판정 5개 | 매번 3/5 | 매번 3/5 |
| 부위별 지방 판정 5개 | 매번 5/5 | 매번 5/5 |
제지방량은 기본 지시문에서 두 번 빠졌는데, 한글 항목명을 넣어 주니 읽었다. 조절·권장값은 측정값과 따로 받았다. 이 값을 회원 목표로 자동 적용하지는 않는다.
사진에 없는 숫자 22개는 세포외수분비, 위상각, 그리고 근육·지방 다섯 부위의 kg과 %다. 이 결과지에는 부위별 판정 문구만 있고 숫자는 없었다. 모델이 없는 숫자를 지어내지 않는지 보려던 항목인데, 다섯 번 모두 null로 남겼다.
다섯 번 다 같은 자리
문제는 부위별 근육 판정이었다. 왼팔의 ‘표준이하’를 몸통에 붙이고 왼팔은 ‘표준’으로 바꿔 버렸다. 다섯 번 모두. 연결선을 확인하라고 지시를 넣어도 그대로였고 몇몇 응답은 경고 목록(warnings)도 비어 있었다.
응답에 경고도 없고 결과도 일관적이었다. 그런데 원본과 대조하면 같은 두 항목을 계속 잘못 연결하고 있었다.
부위별 지방 판정은 이 사진에서는 다섯 번 다 맞았다. 그래도 근육 판정과 같은 그림을 읽는 기능이라 같이 뺐다.
자동 입력에서 뺀 항목
- 상단 핵심 3지표와 상세 기본 4지표는 유지한다.
- 추가로 읽은 숫자 7개는 ‘더 보기’의 선택 항목으로 검토한다.
- 부위별 판정은 자동으로 넣지 않는다. 사용자가 원본 사진에서 확인한다.
- 단위·날짜·필드 의미는 따로 검증하고 저장 전에 사람이 확인한다.
같은 사진 한 장을 반복해서 읽힌 실험이므로 다른 결과지와 촬영 조건에서도 확인이 더 필요하다. 그래서 읽힌 값도 사용자가 원본과 대조한 뒤 저장하도록 했다.
나는 모델을 고르고 추가 실험을 요청했고, 호출과 채점은 코딩 에이전트에 맡겼다. 기능의 범위도 입력 보조로 정했다. 숫자를 옮겨 적는 수고를 줄이되, 결과를 해석하거나 운동을 추천하는 기능은 추가하지 않았다.